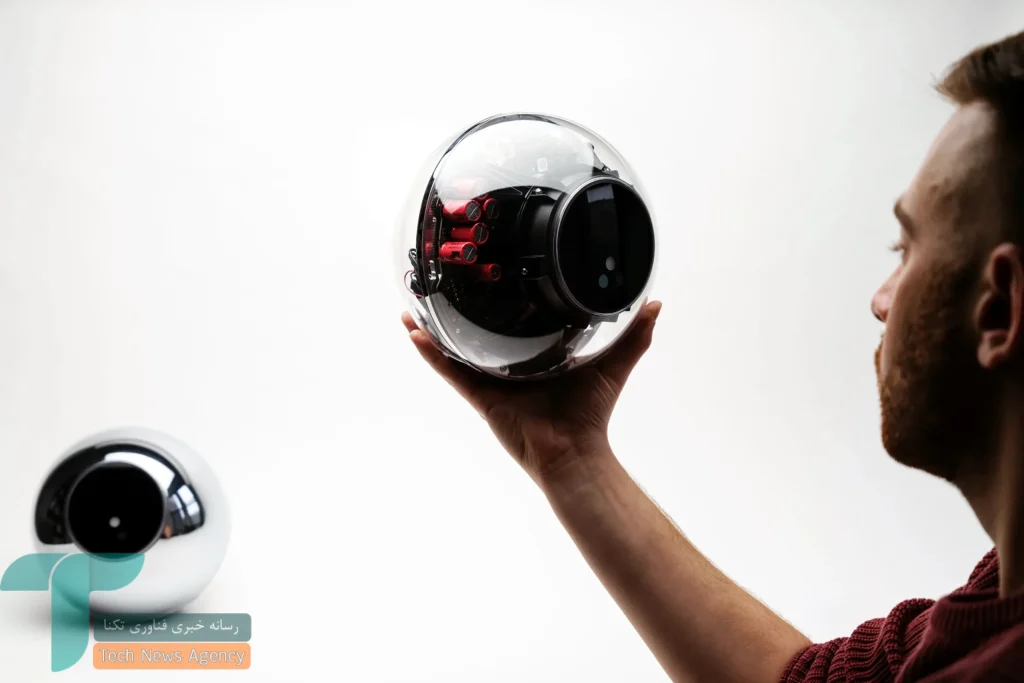

کوالکم به طور رسمی دو شتابدهنده هوش مصنوعی جدید با نامهای AI200 و AI250 را معرفی کرد که به طور اختصاصی برای بارهای کار استنتاج در مقیاس رک (Rack-scale Inference) طراحی شدهاند. ویژگی منحصر به فرد این محصولات، بهرهگیری از حافظه موبایل LPDDR به جای حافظه پهنای باند بالا HBM است که در پردازندههای سروری رایج متداول است. این حرکت، ورود جدی کوالکام به حوزه محاسبات هوش مصنوعی و زیرساختهای دیتاسنتر را پس از تمرکز طولانیمدت بر بازار تلفنهای هوشمند آشکار میسازد.
معماری حافظه نوآورانه: تا ۷۶۸ گیگابایت LPDDR در هر پکیج شتابدهنده
بر اساس گزارشهای منابع نیمهراهبری از جمله تکنا، راهحلهای AI200 و AI250 در پیکربندیهای مقیاس رک ارائه میگردند. این تراشهها قابلیت تعبیه ۷۶۸ گیگابایت حافظه LPDDR مستقیماً روی پکیج شتابدهنده را دارا هستند — ظرفیتی که از محدودیتهای فعلی ماژولهای HBM صنعتی فراتر میرود. این طراحی بر مفهوم «حافظه نزدیک» (Near-Memory) استوار است تا هزینه و انرژی جابجایی داده به شدت کاهش یابد.
🔗 بیشتر بخوانید: چطور به کارمندان ضعیف انگیزه بدهیم؟ ۸ راه انگیزه دادن به کارمندان ضعیف_رنگو
مزایای اصلی رویکرد LPDDR در برابر HBM
- کارایی انرژی برتر: LPDDR با ولتاژ پایینتر و مدیریت توان بهینهتر، مصرف انرژی در هر بیتدرثانیه را کاهش میدهد.
- کاهش چشمگیر هزینه: قیمت واحد حافظه LPDDR به مراتب کمتر از ماژولهای HBM چگال شده است.
- چگالی حافظه بالا: امکان بستهبندی حجم بیشتر در فضای فیزیکی محدود فراهم میشود.
- عملکرد حرارتی بهینه: اتلاف حرارت کمتر، نیازمند راهحلهای خنکسازی سادهتر و ارزانتر میکند.
چالشها و محدودیتهای پیش رو
با وجود مزایای ذکر شده، اجتناب از HBM پیادهسازیهای فعلی کوالکام را با دو محدودیت اساسی مواجه میسازد:
- پهنای باند حافظه کمتر: اینترفیس باریکتر LPDDR در مقایسه با باس عریض HBM، انتقال داده را محدود میکند.
- تأخیر بالاتر: مسیرهای داده طولانیتر و پروتکلهای متفاوت، latency را افزایش میدهند.
بنابراین، این معماری در حال حاضر برای محیطهای سروری پرحرارت و کارکردهای ۲۴/۷ به بلوغ کامل نرسیده و بیشتر برای بارهای کار استنتاجی با حساسیت به هزینه و انرژی مناسب است.
🔗 بیشتر بخوانید: اضافه شدن یادداشت صوتی و اشتراکگذاری تصاویر در چتها_رنگو
موتور پردازش: واحدهای عصبی هگزاگون (Hexagon NPU)
در قلب تراشههای AI200 و AI250، واحدهای پردازش عصبی هگزاگون (Hexagon NPU) قرار دارند که به طور خاص برای کارهای استنتاج بهینهسازی شدهاند. این واحدها از فرمتهای داده پیشرفته (مانند FP8، INT4) و دستورالعملهای متمرکز بر استنتاج پشتیبانی میکنند. کوالکام همچنین از فناوریهای خنکسازی مایع مستقیم، پروتکلهای PCIe و اترنت برای اتصال پرسرعت، و ظرفیت توان ۱۶۰ کیلوواتی در سطح رک بهره میبرد — رقمی که در مقایسه با راهحلهای رقیب، کارایی انرژی چشمگیری را نشان میدهد.
رقابت در حوزه استنتاج هوش مصنوعی
حرکت کوالکام به سمت تراشههای استنتاجی قدرتمند، بخشی از روند گستردهتری در صنعت است. رقبای اصلی عبارتند از:
- اینتل با معماری سیرا فورست (Sierra Forest) و تراشههای Xeon با هستههای کارآمد.
- انویدیا با معماری روبین (Rubin) و شتابدهندههای سری بلکول (Blackwell) متمرکز بر استنتاج.
کوالکام با درک تغییر تقاضا از «آموزش» به «استنتاج»، محصولاتی را عرضه کرده که برای سناریوهای استنتاج مقیاس بزرگ، منطقی و اقتصادی به نظر میرسند. با این حال، برای آموزش مدلهای بزرگ یا بارهای کاری محاسبهگرا، همچنان معماریهای مبتنی بر HBM گزینههای اولویتدار خواهند بود.
پیشبینی بازار و واکنش خردهفروشان
ظهور رقابت در فضای سختافزار هوش مصنوعی، پویایی بازار را تقویت کرده است. گزارشها حاکی از آن است که خردهفروشان و اپراتورهای دیتاسنتر نسبت به راهحلهای کوالکام، خوشبینی قابل توجهی نشان دادهاند — به ویژه در سناریوهایی که مصرف انرژی کلمالکیت (TCO) و تراکم محاسبه در واحد حجم معیارهای تصمیمگیری هستند.